I.Diego. 12/09/2026
Cada nueva edición de PISA, y esta no ha sido la excepción, genera la misma reacción en cadena: un informe de cientos de páginas, una rueda de prensa, y un aluvión de titulares más propios de la prensa deportiva: «Madrid se corona en PISA: número 1 de España y por delante de Finlandia, Suecia y EE. UU.” o “Asturias se coloca a la cabeza de España en PISA: líder en lectura y ciencias ambientales y en el podio científico”.
Frente a esto, siempre surgen voces que nos recuerdan que PISA no es una competición y que comparar posiciones puesto a puesto es, técnicamente, un error de interpretación. Pero nada de esto importa. No solo porque dato no mata relato sino porque la redacción y diseño visual del informe parecen poner en bandeja este tipo de interpretaciones.
La figura que lo dice todo con solo mirarla
Basta un vistazo a cualquiera de las figuras del informe español de la última edición para corroborarlo. Tomemos los resultados en competencia científica como ejemplo y más concretamente la Figura 2.1.b (p.33) que representa los rendimientos medios estimados en ciencias de las comunidades y ciudades autónomas.
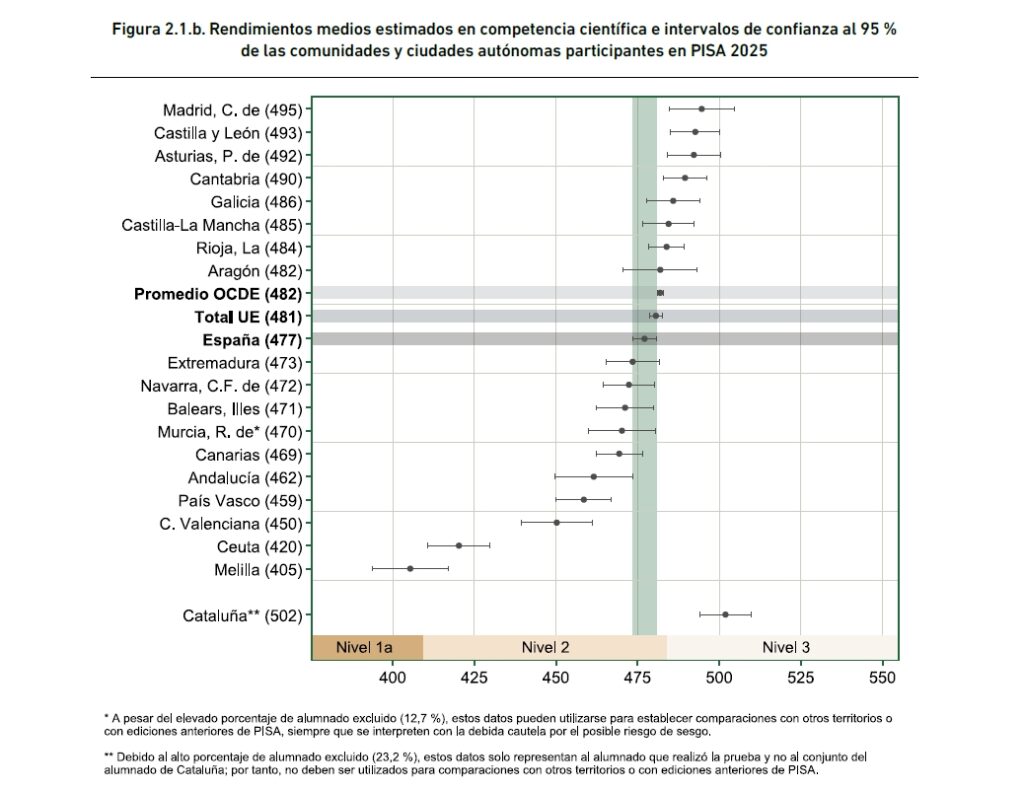
Las comunidades aparecen ordenadas en el eje vertical con su puntuación indicada entre paréntesis. Es exactamente el mismo formato que una clasificación de liga de fútbol salvo por un pequeño detalle: El gráfico incluye las barritas horizontales alrededor de cada punto —los intervalos de confianza al 95% — que son la herramienta correcta para determinar si una diferencia entre dos puntuaciones es real o puede deberse al azar del muestreo. Pero visualmente, esos intervalos quedan en un segundo plano frente al orden descendente y la puntuación absoluta, que es lo primero que capta nuestra atención.
Aunque nada de esto significa que en PISA no haya diferencias reales entre comunidades y ciudades autónomas, esta manera de presentar los datos trae consigo un problema y una paradoja: El problema es que se presentan con una resolución —una clasificación punto por punto de 19 posiciones— que los propios datos no soportan. La paradoja es que el propio gráfico contiene la información necesaria para matizar esta interpretación pero su forma —una lista ordenada— reproduce el lenguaje visual de una lista de clasificación.
Las diferencias entre CCAA existen pero no todas son estadísticamente significativas
Inmediatamente después de la figura anterior, el informe incluye el Cuadro 2.1 (p.34) que para cada país, comunidad o ciudad autónoma, enumera la lista de territorios con los que no presenta diferencias estadísticamente significativas en el rendimiento medio estimado para el indicador en cuestión, en este caso resultados en Ciencias. En otras palabras, es la herramienta que permite leer el gráfico anterior correctamente.
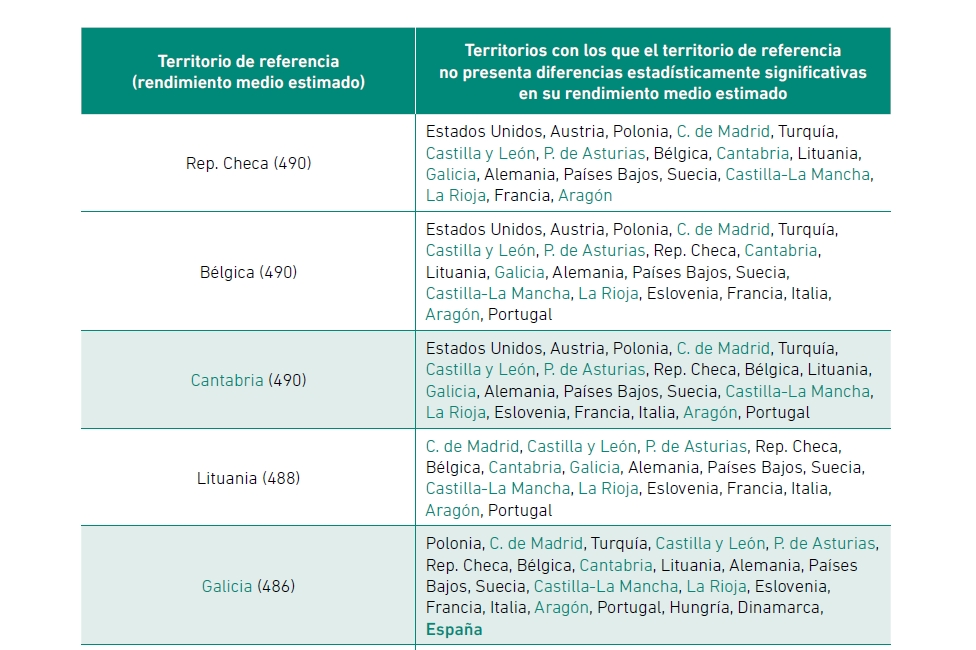
El problema es que el Cuadro 2.1, tal como se publica, es prácticamente ilegible. No ofrece bloques ni grupos, sino un listado por territorio con los nombres de sus «equivalentes» estadísticos, mezclando comunidades autónomas y países sin distinción. Para saber si existen agrupaciones reales entre comunidades autónomas hay que leer las 17 listas a la vez y comprobar, a mano, qué territorios se citan mutuamente unos a otros. Es información correcta, pero entregada en el formato menos accesible posible.
Lo que hemos hecho aquí ha sido justamente ese trabajo: aislar solo las comunidades autónomas de cada una de esas listas y comprobar, territorio a territorio, qué grupos se citan de forma completa y recíproca entre sí (es decir, dónde cada miembro aparece en la lista de todos los demás). Solo así emergen los bloques; en el cuadro original están ahí, pero disueltos en prosa.
Y el resultado, una vez reorganizado, es que en lugar de 19 posiciones distintas aparecen cuatro bloques de rendimiento estadísticamente indistinguible:
- Bloque alto (482-495 puntos): Ocho comunidades con puntuaciones altas ubicadas en un rango de 13 puntos, y ninguna significativamente distinta de las demás: Madrid, Castilla y León, Asturias, Cantabria, Galicia, Castilla-La Mancha, La Rioja y Aragón.
- Bloque medio(462-473 puntos): Seis comunidades con puntuaciones intermedias en un rango de 11 puntos; Extremadura, Navarra, Illes Balears, Murcia, Canarias y Andalucía. Seis comunidades, de nuevo estadísticamente equivalentes entre sí.
- Bloque medio-bajo (450-459 puntos): País Vasco y C. Valenciana.
- Bloque bajo (405-420 puntos): Ceuta y Melilla aparecen claramente por debajo del resto, sin solapamiento con ninguna otra comunidad.
Es decir: de las 19 posiciones que ofrece el ranking de la Figura 2.1.b, la información estadística real sostiene, como mucho, cuatro grupos. De este modo, afirmar que Asturias (492) «supera» a Cantabria (490) o Aragón (482) no tiene respaldo estadístico según el propio informe. Como Asturias no es estadísticamente distinguible de ninguna de las otras siete comunidades autónomas en ese bloque, su posición real podría estar en cualquier punto entre el 1º y el 8º puesto. El dato observado la sitúa en el puesto 3, pero esa posición concreta es solo una entre muchas compatibles con esa incertidumbre muestral.
¿Descalabro para todas por igual?
El informe también contrasta la evolución de puntuaciones en el tiempo y el resultado incomoda al relato dominante de esta edición: España se desploma en ciencias. A nivel nacional es cierto —cae 16 puntos desde 2015, caída significativa—, pero aplicado sin matices a las 17 comunidades no se sostiene.
La Figura 2.11.b (p. 58) identifica con un código de color aquellas comunidades donde la variación de resultados entre las edición 2015 y 2025 de cada comunidad no es significativa. Y ahí aparecen cinco comunidades autónomas: Extremadura (−1), Canarias (−6), Cantabria (−6), Asturias (−9) y Andalucía (−11). El resto sí cae de forma significativa, con casos extremos como Navarra (−40) o C. Valenciana (−44).
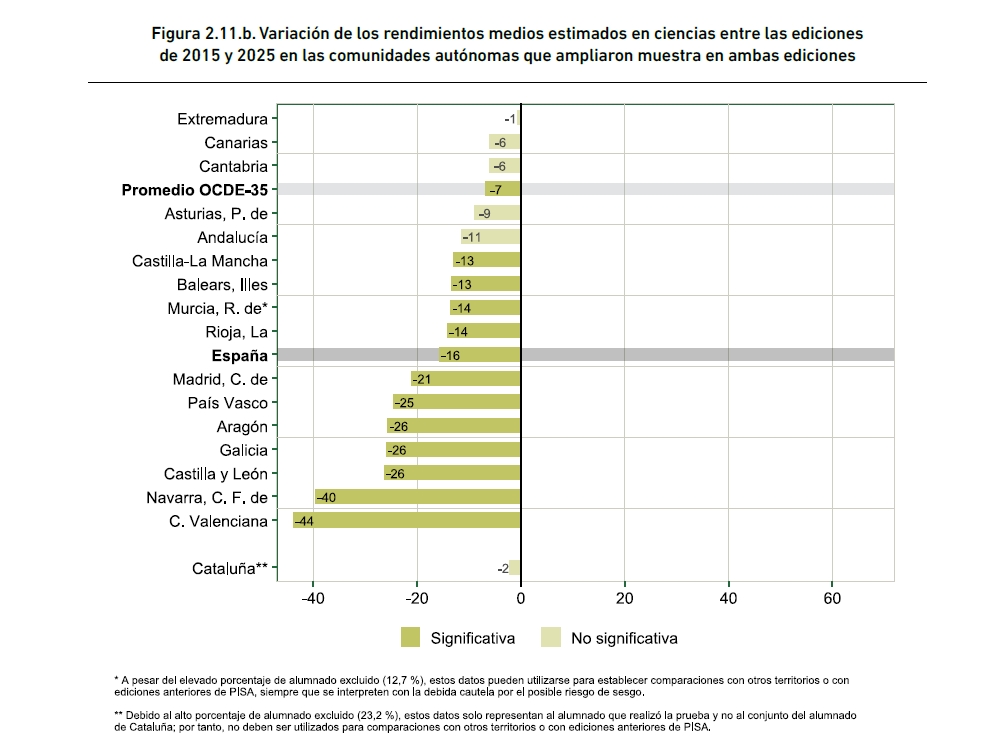
De este modo, por ejemplo, en el bloque con mejores resultados conviven comunidades con descensos significativos (Madrid, Castilla y León, Aragón, Galicia, La Rioja) con otras cuya puntuación es similar a la obtenida en 2015 (Asturias y Cantabria). Al igual que en el Cuadro 2.1, el matiz está codificado en el propio gráfico, pero se pierde camino del titular.
Por qué esto nunca sale en la prensa
Una explicación podría deberse al hecho de que el Cuadro 2.1 y la Figura 2.11.b solo aparecen en el informe completo, que ronda las 442 páginas. El resumen ejecutivo, de apenas 60 páginas y pensado explícitamente para llegar a periodistas, responsables políticos y público general, no los incluye. Es decir: el material que sí circula ampliamente —el que se cita en ruedas de prensa, el que acompaña las notas de la agencia, el que probablemente sea lo único que lea buena parte de quien luego escribe la noticia— es precisamente el que se queda solo con las medias y los gráficos ordenados, sin las herramientas para interpretarlos correctamente. Los datos que permiten la matización estadística están en el documento largo, y ahí la mayoría no llega.
Aunque ninguno de estos cuadros y figuras sean especialmente difíciles de encontrar en el informe completo, exigen un esfuerzo de lectura que el formato no facilita. Como ya se ha mencionado el cuadro 2.1 es una lista de texto, con decenas de nombres por fila, sin visualización que resuma el patrón. Comparado con un gráfico ordenado de mayor a menor, es mucho menos «citable». La Figura 2.11.b corre mejor suerte en ese sentido —es un gráfico de barras, no una tabla de texto—, pero su matiz (los colores que distinguen las variaciones significativas de las que no lo son) exige mirar con atención barra por barra, algo que rara vez sobrevive al paso de un informe de más de 400 páginas a un titular de veinte palabras.
A eso se suma un incentivo político y mediático evidente: una clasificación genera titulares, una banda de equivalencia no. «Ocho comunidades empatadas estadísticamente en cabeza» es un titular honesto pero aburrido; «Madrid a la cabeza de España en PISA» vende más y encaja mejor en un debate territorial ya cargado de comparaciones.
El resultado es que a pesar de que el informe proporciona información para evitar estos errores de interpretación, es sistemáticamente ignorada en la mayoría de las interpretaciones posteriores del resultado.
¿Se repite este patrón en las otras dos competencias?
Todo lo dicho aquí se ha centrado en ciencias, pero el tipo de titulares se repite en matemáticas y en lectura —de hecho, agravado—: en esas dos competencias el informe ni siquiera incluye el cuadro de equivalencias que en ciencias permite, al menos en teoría, distinguir el ruido estadístico de la diferencia real pero sí se puede construir a partir de las tablas de datos disponibles para su descarga en la misma sección de la web donde se ubican los informes.
Con las medias y errores típicos de las 19 comunidades y ciudades autónomas en las tres competencias principales, se puede aplicar exactamente el mismo cálculo del Cuadro 2.1 —la diferencia entre dos territorios dividida por el error combinado de esa diferencia— a lectura y matemáticas, y comprobar si el patrón de ciencias es una excepción o la norma.
No lo es:
| Competencia | Pares no significativos | Pares significativos |
|---|---|---|
| Ciencias | 58 de 171 (33,9%) | 113 (66,1%) |
| Lectura | 52 de 171 (30,4%) | 119 (69,6%) |
| Matemáticas | 60 de 171 (35,1%) | 111 (64,9%) |
En las tres competencias, entre un 30% y un 35% de todas las comparaciones posibles entre comunidades autónomas no son estadísticamente significativas. El patrón que veníamos documentando en ciencias no es una excepción, es transversal a las tres materias.
Pero el ejercicio más interesante es más exigente: en vez de mirar cada competencia por separado, se puede pedir que la ausencia de diferencia entre dos territorios se sostenga simultáneamente en ciencias, lectura y matemáticas —la intersección de los tres cálculos, no la unión—. Es el criterio más difícil de superar, y aun así 9 comunidades autónomas como mínimo (5 de una cabecera con dos variantes solapadas, más un bloque medio-bajo conformado por Andalucía, Illes Balears, Canarias y Murcia) forman grupos internamente equivalentes de forma robusta en las tres materias a la vez. En total, entre 10 y 11 de los 19 territorios tienen al menos un «gemelo estadístico» que resiste este criterio tan exigente.
Dicho de otro modo: más de la mitad de las 17 comunidades autónoma (9 de 17) pertenecen a grupos donde la variabilidad observada en las puntuaciones absolutas es, con toda probabilidad, ruido de muestreo — y eso exigiendo el criterio más estricto posible, que se sostenga en las tres competencias a la vez, no solo en una. No es un hallazgo aislado de una materia con peor diseño muestral; es estructural al nivel de desagregación que se está publicando.
¿Qué nos dice el informe PISA sobre la competencia matemática de la población adulta que comentamos sus resultados?
Cabe preguntarse, además, si esa ignorancia sistemática responde a que esa información simplemente no se llega a leer o a que, aun leyéndola, no se cuenta con la competencia necesaria para interpretarla correctamente. Ambas explicaciones son compatibles, pero no son lo mismo: una es un problema de acceso a la información; la otra, un problema de competencia matemática —leer una tabla de intervalos de confianza, entender qué significa que dos bandas se solapen— que no depende de haber llegado o no a la página 34 del informe completo.